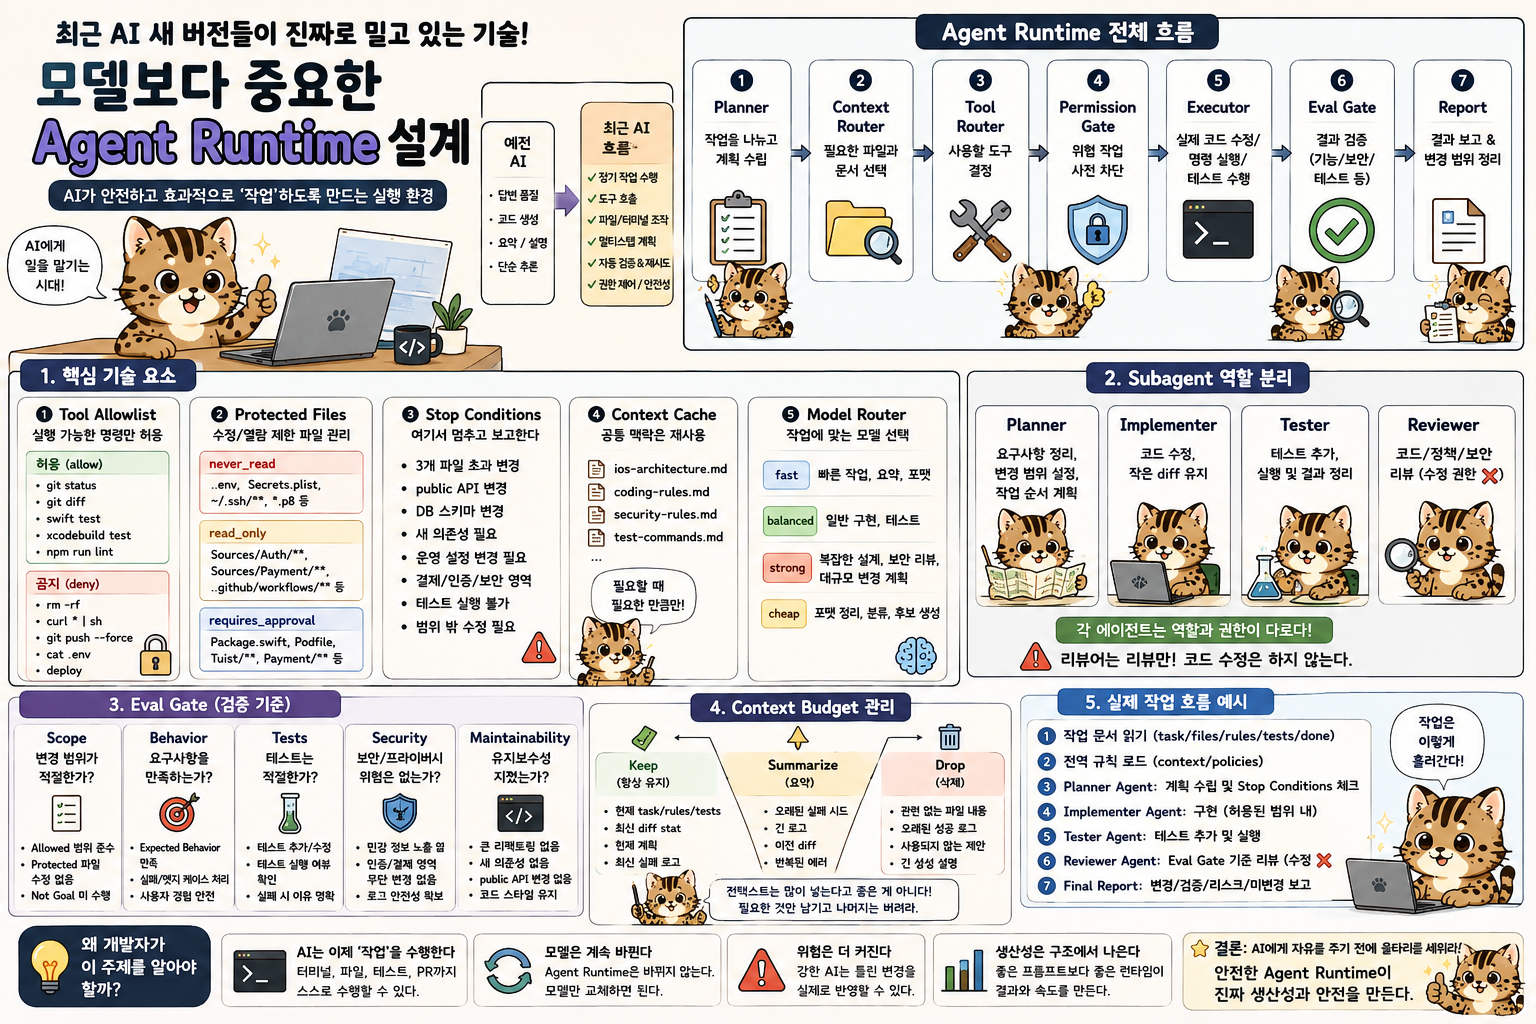
최근 AI 모델 새 버전들이 계속 나오고 있다.
이제는 발표 문구도 거의 비슷하다.
더 긴 컨텍스트
더 강한 코딩 능력
더 좋은 추론
더 빠른 응답
더 싼 모델
더 강한 에이전트 작업
처음에는 모델 이름만 보게 된다.
이번엔 누가 더 똑똑한가.
코딩 벤치마크가 몇 점인가.
컨텍스트 창이 몇 토큰인가.
이전 모델보다 얼마나 빠른가.
그런데 실제 개발자가 봐야 할 핵심은 조금 다르다.
요즘 AI 새 버전들이 공통으로 향하는 방향은 단순히 “채팅 답변을 잘하는 모델”이 아니다.
진짜 흐름은 이것에 가깝다.
AI가 직접 파일을 읽고,
도구를 호출하고,
터미널을 실행하고,
작업을 나누고,
실패하면 다시 시도하고,
결과를 검증하는 구조
즉, 모델 경쟁의 다음 단계는 Agent Runtime이다.
모델 하나를 잘 고르는 시대에서,
모델이 안전하게 일할 수 있는 실행 환경을 설계하는 시대로 넘어가고 있다.
이 글에서는 최근 AI 새 버전들이 왜 에이전트 중심으로 가고 있는지, 그리고 개발자가 실제로 어떤 기술 스택을 준비해야 하는지 정리해본다.
1. 요즘 AI가 핫한 이유는 “답변”이 아니라 “작업” 때문이다
예전 AI 사용은 대부분 질문형이었다.
이 코드 설명해줘.
이 함수 리팩토링해줘.
이 에러 왜 나는지 알려줘.
이때 AI는 조수에 가까웠다.
개발자가 작업을 하고, AI는 옆에서 대답했다.
그런데 최근 도구들은 다르게 움직인다.
이 이슈를 읽고 원인 찾아줘.
관련 파일 확인해줘.
수정 계획 세워줘.
테스트 추가해줘.
실패 로그 보고 다시 고쳐줘.
PR 설명까지 써줘.
이건 채팅이 아니다.
작업 위임이다.
AI가 답을 하는 게 아니라, 개발 환경 안에서 직접 움직이는 것이다.
그래서 최근 AI 새 버전들이 강조하는 능력도 바뀌고 있다.
이전 세대:
- 답변 품질
- 코드 생성
- 요약
- 번역
- 간단한 추론

최근 흐름:
- 장기 작업
- 도구 호출
- 파일 시스템 탐색
- 터미널 실행
- 멀티스텝 계획
- subagent 분리
- 권한 제어
- 컨텍스트 관리
- 자동 평가
여기서 중요한 건 모델 자체보다 모델 주변의 실행 구조다.
모델이 아무리 좋아도, 아무 파일이나 읽고 아무 명령이나 실행하면 실무에서는 위험하다.
반대로 모델이 조금 약해도, 컨텍스트와 도구 권한을 잘 설계하면 훨씬 안정적으로 일할 수 있다.
2. 긴 컨텍스트가 모든 문제를 해결하지 않는다
요즘 모델들은 긴 컨텍스트를 자랑한다.
몇십만 토큰, 백만 토큰, 그 이상.
처음 보면 이런 생각이 든다.
그럼 그냥 repo 전체를 넣으면 되겠네?하지만 실무에서는 그렇게 단순하지 않다.
repo 전체를 넣으면 AI가 더 똑똑해질 것 같지만, 실제로는 헷갈릴 수 있다.
사람에게도 똑같다.
작은 버그 하나 고치라고 했는데,
전체 코드베이스, 회사 문서, 3년치 PR, 장애 리포트, 회의록을 한꺼번에 던져주면 더 잘할까?
아니다.
중요한 내용을 찾는 비용이 커진다.
AI도 마찬가지다.
긴 컨텍스트는 강력하지만, 무식하게 많이 넣는다고 좋은 결과가 나오지는 않는다.
요즘 필요한 스킬은 “Long Context에 다 넣기”가 아니라 Context Routing이다.
필요한 순간에
필요한 파일만
필요한 형태로
필요한 만큼만
모델에게 넣는 것
이게 최근 말하는 Context Engineering의 실전 버전이다.
3. Agent Runtime이란 뭘까
Agent Runtime이라는 말을 거창하게 들을 필요는 없다.
개발자식으로 보면 이런 구조다.
User Task
→ Planner
→ Context Router
→ Tool Router
→ Permission Gate
→ Executor
→ Eval Gate
→ Report
각 역할은 명확하다.
Planner:
작업을 나눈다.

Context Router:
어떤 파일과 문서를 읽을지 고른다.

Tool Router:
어떤 도구를 쓸지 정한다.

Permission Gate:
위험한 작업을 막는다.

Executor:
실제 수정, 명령 실행, 테스트를 수행한다.

Eval Gate:
결과가 기준을 만족하는지 검증한다.

Report:
무엇을 했고, 무엇을 안 했는지 보고한다.
이제 AI 도구를 잘 쓰는 팀은 단순히 “좋은 모델을 쓴다”에서 끝나지 않는다.
이 런타임을 만든다.
4. 실무형 Agent Runtime 폴더 구조
팀에서 AI 코딩 에이전트를 제대로 쓰려면 이런 구조를 만들 수 있다.
.ai/
├── agents/
│   ├── planner.md
│   ├── implementer.md
│   ├── reviewer.md
│   └── tester.md
├── context/
│   ├── architecture.md
│   ├── coding-rules.md
│   ├── security-rules.md
│   └── test-commands.md
├── policies/
│   ├── tool-allowlist.yaml
│   ├── protected-files.yaml
│   └── stop-conditions.md
├── evals/
│   ├── pr-review.checklist.md
│   ├── security.checklist.md
│   └── regression.checklist.md
└── tasks/
    └── checkout-duplicate-submit/
        ├── task.md
        ├── files.md
        ├── rules.md
        ├── tests.md
        └── done.md
이 구조의 핵심은 단순하다.
전역 규칙은 .ai/context와 .ai/policies에 둔다.
작업별 맥락은 .ai/tasks 안에 둔다.
에이전트 역할은 .ai/agents에 둔다.
검증 기준은 .ai/evals에 둔다.
AI에게 매번 긴 설명을 붙일 필요가 없다.
작업할 때 이렇게 말하면 된다.
.ai/tasks/checkout-duplicate-submit/ 문서를 기준으로 작업해줘.
전역 규칙은 .ai/context, .ai/policies를 따라.
구현 전 planner.md 방식으로 계획을 먼저 세워.
이제 AI는 그냥 막 움직이는 게 아니라, 팀이 만들어둔 작업장 안에서 움직인다.
5. 핵심 기술 1: Tool Allowlist
요즘 AI 에이전트는 터미널을 실행할 수 있다.
이게 강력하지만 제일 위험하다.
AI에게 터미널 권한을 줬다면, 가장 먼저 할 일은 허용 명령과 금지 명령을 나누는 것이다.
# .ai/policies/tool-allowlist.yaml

allowed_commands:
  - git status
  - git diff
  - git diff --stat
  - swift test
  - xcodebuild test
  - npm test
  - npm run lint
  - ./gradlew test

blocked_patterns:
  - rm -rf
  - git push --force
  - curl * | sh
  - wget * | sh
  - chmod 777
  - sudo
  - ssh
  - scp
  - open .env
  - cat .env
  - printenv
  - deploy
  - kubectl
  - terraform apply
AI에게 “테스트 실행해줘”는 괜찮다.
하지만 “뭐든 알아서 해줘”는 안 된다.
특히 다음 명령은 조심해야 한다.
삭제 명령
권한 변경
원격 접속
환경 변수 출력
배포 명령
운영 인프라 변경
강제 push
설치 스크립트 실행
AI가 나쁜 의도로 실행하지 않더라도, 잘못된 판단으로 위험한 명령을 실행할 수 있다.
그래서 Tool Allowlist는 필수다.
6. 핵심 기술 2: Protected Files
AI에게 수정하면 안 되는 파일을 알려줘야 한다.
예를 들어 이런 파일들이다.
# .ai/policies/protected-files.yaml

protected_files:
  - .env
  - .env.*
  - fastlane/Appfile
  - fastlane/Matchfile
  - ios/Config/Production.xcconfig
  - android/keystore.properties
  - .github/workflows/deploy.yml
  - scripts/deploy.sh
  - terraform/**
  - k8s/**
  - secrets/**
  - DesignSystem/**
  - NetworkCore/**

requires_approval:
  - Package.swift
  - package.json
  - Podfile
  - Cartfile
  - project.yml
  - Tuist/**
  - Payment/**
  - Auth/**
  - Analytics/**
이 파일들이 무조건 수정 불가라는 뜻은 아니다.
다만 AI가 혼자 조용히 수정하면 안 되는 파일이라는 뜻이다.
에이전트에게 이렇게 지시한다.
protected_files에 걸리는 파일은 수정하지 마.
requires_approval에 해당하면 계획만 세우고 멈춰.
이 한 줄이 생각보다 중요하다.
AI는 문제를 해결하려고 하다가 의존성을 추가하거나, 빌드 설정을 바꾸거나, 공통 모듈을 수정할 수 있다.
그게 필요한 경우도 있지만, 사람 승인 없이 들어가면 위험하다.
7. 핵심 기술 3: Stop Conditions
AI 에이전트는 너무 열심히 한다.
그래서 멈춰야 할 조건을 줘야 한다.
# .ai/policies/stop-conditions.md

Stop and report before editing if:

- More than 3 files need to change.
- A public API must change.
- A database schema must change.
- A new dependency seems necessary.
- A production config file needs to change.
- The task touches payment, auth, privacy, or security.
- The required fix is outside Allowed to Edit files.
- Tests cannot be executed and the change is high risk.
- Existing behavior is unclear from the task document.
이건 정말 효과가 있다.
AI에게 “막히면 물어봐”라고 하면 잘 안 멈춘다.
대신 구체적으로 멈추는 조건을 줘야 한다.
3개 파일 넘으면 멈춰.
새 라이브러리 필요하면 멈춰.
public API 바꿔야 하면 멈춰.
결제나 인증 건드리면 멈춰.
좋은 에이전트 운영은 AI를 잘 달리게 하는 것만이 아니다.
잘 멈추게 만드는 것도 운영이다.
8. 핵심 기술 4: Context Cache
AI에게 매번 같은 설명을 반복하면 비효율적이다.
그래서 프로젝트 공통 맥락은 캐시처럼 관리하는 게 좋다.
예를 들어 iOS 앱이라면 이런 문서를 둔다.
# .ai/context/ios-architecture.md

## Architecture

- SwiftUI View displays UI only.
- ViewModel owns UI state and is MainActor-isolated.
- UseCase owns business flow.
- Repository owns data access.
- API client owns network transport.
- View must not call API directly.
- ViewModel must not parse raw JSON.
- Repository must not decide UI messages.

## State

- Loading state should be explicit.
- Error message should be user-safe.
- Duplicate submit should be guarded in ViewModel.
- UI mutation should happen on MainActor.

## Tests

- ViewModel tests are preferred for UI state transitions.
- UseCase tests are preferred for business rules.
- Repository tests should mock network transport.
이 문서는 매번 프롬프트에 붙이는 게 아니다.
AI가 작업 시작 전에 읽도록 한다.
Before working, read:
.ai/context/ios-architecture.md
.ai/context/security-rules.md
.ai/context/test-commands.md
이게 Context Cache다.
전체 repo를 다 먹이는 대신, 자주 쓰는 팀 규칙을 짧고 재사용 가능한 문서로 만든다.
9. 핵심 기술 5: Model Router
최근 AI 새 버전들은 모델 라인업을 여러 개로 나누는 흐름이 강하다.
강한 모델, 빠른 모델, 저렴한 모델, 코딩 특화 모델, 긴 컨텍스트 모델.
문제는 모든 작업에 가장 강한 모델을 쓰면 비효율적이라는 점이다.
실무에서는 모델 라우팅이 필요하다.
# .ai/policies/model-router.yaml

tasks:
  summarize_diff:
    model: fast
    reason: "짧은 요약은 빠른 모델로 충분"

  generate_test_names:
    model: fast
    reason: "후보 생성 작업"

  inspect_architecture:
    model: strong
    reason: "여러 파일과 설계 판단 필요"

  implement_low_risk_task:
    model: balanced
    reason: "일반 구현"

  review_security_sensitive_diff:
    model: strong
    reason: "보안, 개인정보, 인증 영역"

  plan_large_refactor:
    model: strong
    reason: "장기 계획과 영향도 분석 필요"

  format_markdown:
    model: cheap
    reason: "형식 정리"
이 기준이 있으면 AI 비용과 품질을 같이 관리할 수 있다.
예를 들어 이런 식이다.
빠른 모델:
- diff 요약
- 문서 포맷
- 테스트 이름 후보
- 단순 분류

균형 모델:
- 일반 코드 수정
- 테스트 추가
- PR 설명 작성

강한 모델:
- 아키텍처 분석
- 보안 리뷰
- 복잡한 버그
- 대규모 리팩토링 계획
앞으로 개발팀은 “어떤 모델이 제일 좋은가?”보다 “이 작업에 어떤 모델을 붙일 것인가?”를 고민하게 될 가능성이 높다.
10. 핵심 기술 6: Subagent 분리
요즘 에이전트 도구들이 subagent를 강조하는 이유가 있다.
개발 작업은 원래 역할이 나뉜다.
기획 읽는 사람
코드 찾는 사람
구현하는 사람
테스트하는 사람
리뷰하는 사람
배포 위험 보는 사람
AI도 하나의 에이전트가 다 하게 만들면 결과가 흐려질 수 있다.
역할을 나누는 편이 좋다.
Planner Agent:
- 요구사항 정리
- 변경 범위 제한
- 작업 순서 작성

Implementer Agent:
- 실제 코드 수정
- 작은 diff 유지

Tester Agent:
- 테스트 케이스 확인
- 테스트 실행 결과 정리

Reviewer Agent:
- 변경 범위 검토
- 보안/개인정보 위험 확인
- 팀 규칙 위반 확인
예를 들어 .ai/agents/reviewer.md는 이렇게 쓸 수 있다.
# Reviewer Agent

You are not allowed to edit code.

Your job is to review the diff against:

- task.md
- files.md
- rules.md
- tests.md
- done.md
- .ai/context/security-rules.md
- .ai/policies/protected-files.yaml

Check:

- Did the implementation satisfy the task?
- Did it modify files outside Allowed to Edit?
- Did it touch protected files?
- Did it add dependencies?
- Did it change public APIs?
- Were tests added or updated?
- Were tests actually executed?
- Is there any privacy or security risk?

Return only:

## Verdict

Pass / Needs Changes / Blocked

## Issues

## Required Fixes

## Risk
핵심은 Reviewer Agent에게 코드 수정 권한을 주지 않는 것이다.
리뷰어는 리뷰만 한다.
이렇게 역할을 제한해야 결과가 깔끔해진다.
11. 핵심 기술 7: Eval Gate
AI 에이전트 작업에서 제일 중요한 건 “끝났다고 말하는 것”이 아니다.
끝났는지 검증하는 것이다.
그래서 Eval Gate가 필요하다.
예를 들어 PR 리뷰용 체크리스트를 둔다.
# .ai/evals/pr-review.checklist.md

## Scope

- 변경 파일이 Allowed to Edit 범위 안에 있는가?
- Not Goal에 해당하는 작업을 하지 않았는가?
- protected_files를 수정하지 않았는가?

## Behavior

- 요구사항의 Expected Behavior를 만족하는가?
- 실패 케이스가 처리되었는가?
- 중복 실행, 빈 상태, 네트워크 실패 같은 기본 상태가 안전한가?

## Tests

- 필요한 테스트가 추가되었는가?
- 테스트 명령이 실행되었는가?
- 실행하지 못했다면 이유가 명확한가?

## Security

- 민감 정보 로그가 추가되지 않았는가?
- 인증, 결제, 권한 관련 변경이 사람 승인 없이 들어가지 않았는가?

## Maintainability

- 큰 리팩토링이 섞이지 않았는가?
- 새 의존성이 추가되지 않았는가?
- public API 변경이 없는가?
AI에게 구현 후 이렇게 시킨다.
이제 .ai/evals/pr-review.checklist.md 기준으로 self-review 해줘.
코드는 수정하지 말고, 통과/실패/위험만 보고해.
이게 Eval Gate다.
단순히 테스트만 보는 게 아니다.
범위, 보안, 유지보수성, 정책 위반까지 같이 본다.
12. 실제 작업 프롬프트는 이렇게 짧아진다
Agent Runtime을 만들어두면 프롬프트는 오히려 짧아진다.
.ai/tasks/checkout-duplicate-submit/ 작업을 진행해줘.

반드시 따를 것:
- .ai/context/ios-architecture.md
- .ai/context/security-rules.md
- .ai/policies/tool-allowlist.yaml
- .ai/policies/protected-files.yaml
- .ai/policies/stop-conditions.md

순서:
1. Planner Agent 방식으로 계획 작성
2. Stop Conditions 확인
3. Allowed to Edit 범위 안에서만 구현
4. tests.md 기준으로 테스트 추가
5. 가능한 테스트 명령 실행
6. Eval Gate 기준으로 self-review
7. Final Report 작성

Final Report 형식:

## Summary
## Files Changed
## Validation
## Eval Result
## Risk
## Not Changed
이 프롬프트의 포인트는 자세한 요구사항을 채팅창에 길게 쓰지 않는 것이다.
요구사항과 규칙은 파일에 있다.
AI에게는 그 파일을 기준으로 움직이라고만 시킨다.
이 방식이 좋은 이유는 반복 가능하기 때문이다.
한 번 잘 만든 런타임은 다음 작업에서도 재사용된다.
13. 기술적으로 더 들어가면: Context Budget을 관리해야 한다
AI 에이전트를 쓰다 보면 컨텍스트가 금방 더러워진다.
처음에는 깔끔하다.
task.md
files.md
rules.md
tests.md
그런데 작업을 하다 보면 이런 것들이 쌓인다.
수정 계획
파일 내용
에러 로그
테스트 실패 로그
중간 추론
다시 수정한 내용
새 diff
다시 테스트한 로그
이걸 전부 계속 들고 가면 모델이 점점 흐려진다.
그래서 Context Budget 규칙이 필요하다.
# .ai/policies/context-budget.md

## Keep in Context

- Current task.md
- Current files.md
- Current rules.md
- Current tests.md
- Current diff stat
- Latest test failure only
- Current implementation plan

## Summarize

- Old failed attempts
- Long logs
- Previous diffs
- Repeated compiler errors

## Drop

- Irrelevant file contents
- Old successful logs
- Unused suggestions
- Long generated explanations
이게 은근히 중요하다.
긴 컨텍스트 모델을 쓰더라도, 작업 컨텍스트는 계속 청소해야 한다.
좋은 에이전트는 많이 기억하는 에이전트가 아니라, 지금 필요한 것을 남기고 나머지를 잘 버리는 에이전트다.
14. 기술적으로 더 들어가면: Diff-first Review를 써라
AI가 만든 결과를 리뷰할 때 전체 파일을 다시 읽히는 것보다 diff를 기준으로 리뷰시키는 편이 좋다.
git diff --stat > .ai/tasks/checkout-duplicate-submit/diff-stat.txt
git diff > .ai/tasks/checkout-duplicate-submit/diff.patch
그다음 이렇게 시킨다.
diff.patch만 기준으로 리뷰해줘.

확인할 것:
- task.md의 Expected Behavior를 만족하는가
- files.md의 Allowed to Edit 범위를 넘었는가
- rules.md를 어긴 부분이 있는가
- tests.md의 Required Test Cases가 반영되었는가
- protected-files.yaml을 위반했는가
- public API 변경이 있는가
- 새 의존성이 추가되었는가

코드 수정하지 말고 리뷰만 해.
이 방식이 좋은 이유는 명확하다.
AI가 “프로젝트 전체를 보고 느낌으로 리뷰”하지 않고, 실제 변경분만 본다.
사람 리뷰도 결국 diff 중심이다.
AI 리뷰도 diff 중심으로 가야 한다.
15. 기술적으로 더 들어가면: 실패 로그는 마지막 것만 먹여라
AI에게 테스트 실패를 고치게 할 때 흔히 하는 실수가 있다.
실패 로그를 전부 붙인다.
첫 번째 실패, 두 번째 실패, 세 번째 실패, 전체 빌드 로그, 경고 로그까지 다 넣는다.
그러면 AI가 어디에 집중해야 할지 흐려진다.
대신 이렇게 정리해서 준다.
Latest Failure Only

Command:
xcodebuild test -scheme MyApp -destination 'platform=iOS Simulator,name=iPhone 16'

Failure:
CheckoutViewModelTests.test_submitOrder_whenFailed_allowsRetry

Error:
XCTAssertFalse failed: isSubmitting is still true after failure

Relevant File:
CheckoutViewModel.swift
CheckoutViewModelTests.swift

Expected:
When createOrder fails, isSubmitting should become false and retry should be possible.
이게 훨씬 낫다.
AI에게 로그를 던지지 말고, 실패를 압축해서 줘라.
이것도 Context Engineering이다.
16. 기술적으로 더 들어가면: Human Approval Gate를 명시해라
AI에게 맡기면 안 되는 영역은 명확히 분리해야 한다.
예를 들어 이런 작업은 승인 없이 진행하면 안 된다.
결제 API 변경
인증 플로우 변경
개인정보 로그 변경
DB 마이그레이션
배포 파이프라인 수정
운영 설정 변경
신규 의존성 추가
암호화/보안 로직 변경
정책 파일로 둔다.
# .ai/policies/human-approval.md

Human approval is required before editing:

- Payment/**
- Auth/**
- Privacy/**
- Security/**
- Database/**
- .github/workflows/**
- fastlane/**
- scripts/deploy.sh
- Production configuration files

The agent may:

- Read these files for context.
- Suggest a plan.
- Explain why a change may be needed.

The agent must not:

- Edit these files.
- Generate secrets.
- Print secrets.
- Run deployment commands.
- Change production behavior without approval.
AI에게 읽기 권한과 수정 권한을 구분해야 한다.
읽어도 되는 파일
수정해도 되는 파일
승인 전에는 수정하면 안 되는 파일
절대 열면 안 되는 파일
이 구분이 없으면 위험하다.
17. 결국 최신 AI 스킬은 “프롬프트”가 아니라 “운영체제”에 가깝다
예전에는 프롬프트 한 줄을 잘 쓰는 게 중요했다.
너는 시니어 개발자야.
깔끔하게 리팩토링해줘.
이런 식이었다.
그런데 최근 AI 새 버전들과 에이전트 도구들을 보면 방향이 다르다.
이제는 프롬프트 한 줄보다 주변 시스템이 중요하다.
Context Pack
Tool Allowlist
Protected Files
Stop Conditions
Context Cache
Model Router
Subagents
Eval Gate
Human Approval Gate
Diff-first Review
Context Budget
이걸 합치면 작은 Agent Runtime이 된다.
AI에게 일을 시킨다는 건 이제 단순히 채팅창에 요청하는 게 아니다.
작업 환경을 설계하는 것이다.
18. 마무리
최근 AI 새 버전들이 핫한 이유는 단순히 더 똑똑해서가 아니다.
이제 모델들이 개발 환경 안에서 직접 움직일 만큼 강해지고 있기 때문이다.
하지만 그만큼 위험도 커졌다.
약한 AI는 틀린 답을 한다.
강한 AI는 틀린 변경을 실제 파일에 반영한다.
그래서 개발자에게 필요한 스킬도 바뀐다.
예전:
AI에게 질문 잘하기

지금:
AI가 안전하게 일할 수 있는 런타임 만들기
좋은 개발팀은 앞으로 모델 이름만 따라가지 않을 것이다.
대신 이런 질문을 할 것이다.
우리 repo에는 AGENTS.md가 있는가?
에이전트가 수정하면 안 되는 파일이 정의되어 있는가?
실행 가능한 명령과 금지 명령이 나뉘어 있는가?
작업별 Context Pack이 있는가?
테스트 실패 로그를 압축해서 전달하는가?
subagent 역할이 분리되어 있는가?
AI가 만든 diff를 Eval Gate로 검증하는가?
사람 승인 없이 건드리면 안 되는 영역이 막혀 있는가?
AI 모델은 계속 바뀐다.
오늘은 이 모델이 좋고, 내일은 다른 모델이 좋아질 수 있다.
하지만 Agent Runtime을 잘 만들어둔 팀은 모델이 바뀌어도 흔들리지 않는다.
모델만 갈아끼우면 되기 때문이다.
결국 최근 AI 시대의 진짜 스킬은 이것이다.
모델을 잘 고르는 것보다,
모델이 일할 수 있는 안전한 작업장을 만드는 것
이게 앞으로 개발자들이 가져가야 할 가장 실전적인 AI 스킬이다.
참고 자료
- Anthropic Engineering: Effective context engineering for AI agents
- Claude Code Docs: Hooks reference
- Claude Code Docs: Plugins, skills, subagents, and MCP
- Google AI for Developers: Gemini API Long Context
- Google Gemini Code Assist Release Notes
- GitHub Copilot: Coding agents and autonomous task execution
- arXiv: Building AI Coding Agents for the Terminal
- arXiv: Dive into Claude Code and future AI agent systems
- arXiv: Coding Agents are Effective Long-Context Processors
'IT' 카테고리의 다른 글
| AI Agent Runtime의 다음 진화: Stateless Core + Stateful Application 아키텍처 (1) | 2026.07.18 |
|---|---|
| AI 에이전트가 어제 한 일을 잊지 않게 만드는 법: Durable Memory와 Run Ledger 설계 (1) | 2026.07.18 |
| AI 코딩 에이전트 성능을 확 올리는 실전 스킬: Context Pack 만들기 (0) | 2026.07.18 |
| iOS 앱에 AI를 붙일 때, 이제 서버부터 생각하면 늦다 - 온디바이스 LLM (1) | 2026.07.18 |
| GPT-5.6 발표로 보는 AI 에이전트 개발 워크플로 설계법 (0) | 2026.07.18 |