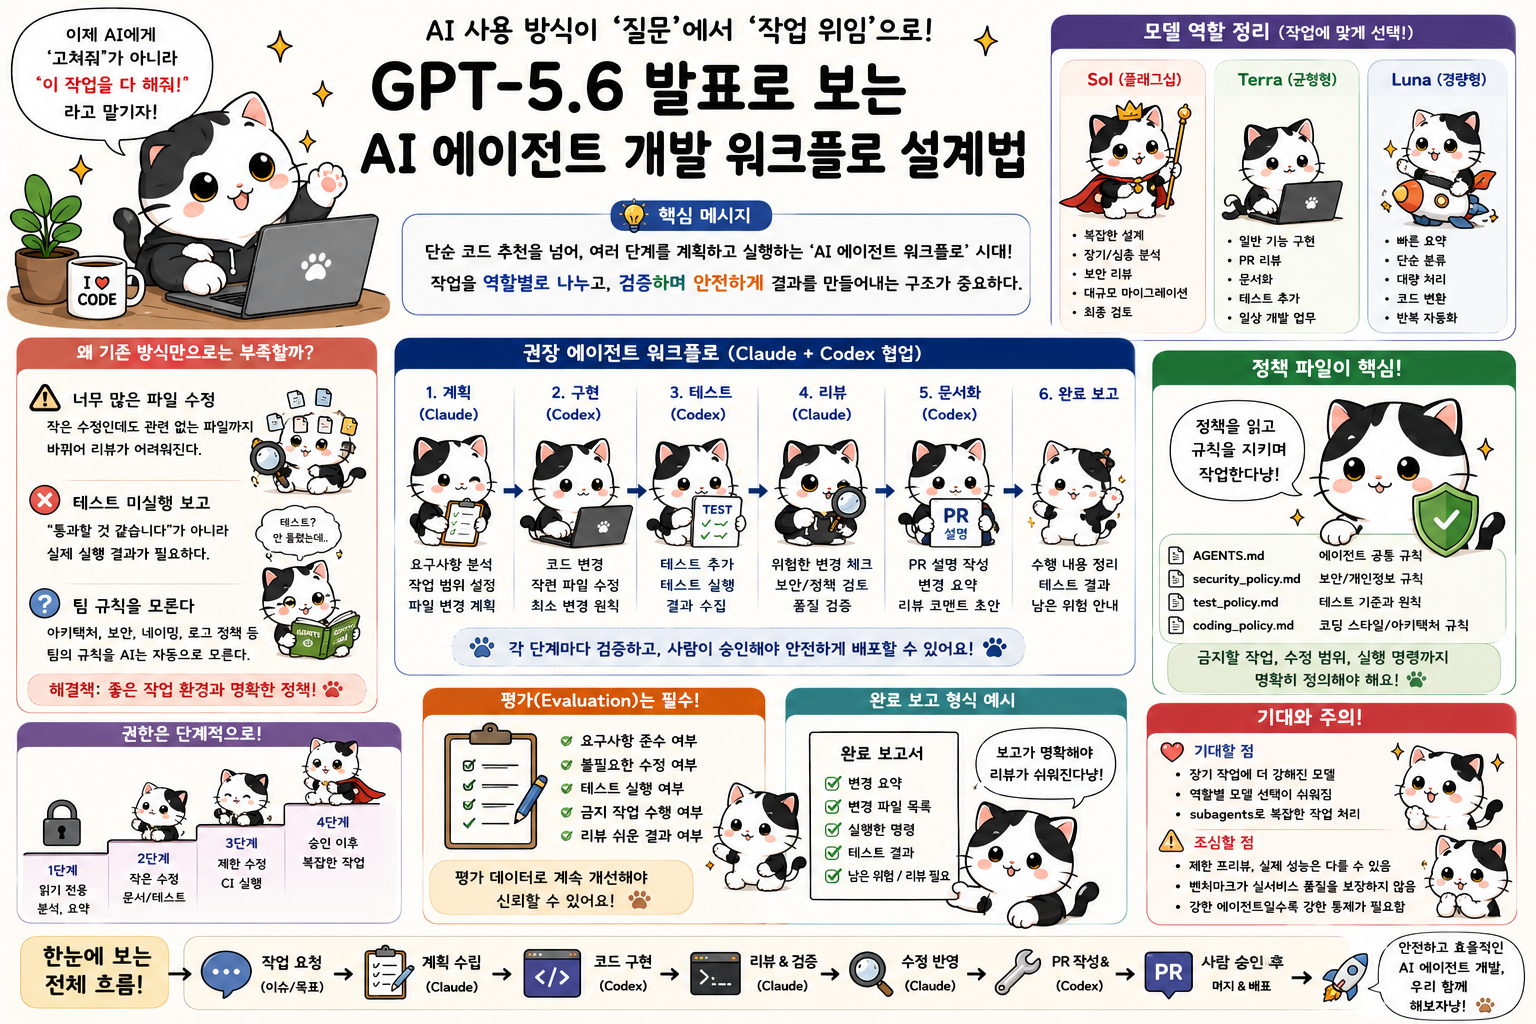
OpenAI가 GPT-5.6 시리즈를 공개했다.
이번 발표에서 눈에 띄는 이름은 세 가지다.
GPT-5.6 Sol
GPT-5.6 Terra
GPT-5.6 Luna
Sol은 플래그십 모델, Terra는 일상적인 개발·업무에 맞춘 균형형 모델, Luna는 빠르고 비용 효율적인 모델로 소개됐다.
하지만 개발자 입장에서 이번 발표를 단순히 “새 모델이 더 좋아졌다” 정도로만 보면 조금 아쉽다.
이번 발표에서 더 중요하게 봐야 할 부분은 모델 이름보다 에이전트 워크플로의 변화다.
GPT-5.6 Sol에는 더 깊은 추론을 위한 max reasoning effort가 추가됐고, 복잡한 작업을 subagents로 나눠 처리하는 ultra 모드도 함께 소개됐다.
이건 단순히 답변 품질이 좋아진다는 의미를 넘어서, AI가 개발 업무를 처리하는 방식이 바뀌고 있다는 신호에 가깝다.
예전에는 AI에게 이렇게 물었다.
이 함수 리팩토링해줘.이제는 점점 이렇게 맡기는 방향으로 가고 있다.
이 이슈를 분석하고, 관련 파일을 찾고, 수정 계획을 세우고,
테스트를 추가한 뒤, PR 설명까지 작성해줘.
즉, AI 사용 방식이 “질문”에서 “작업 위임”으로 이동하고 있다.
이 글은 GPT-5.6의 실제 장기 사용 후기가 아니다. OpenAI 공식 발표와 초기 공개 자료를 바탕으로, 개발팀이 자체 AI 에이전트 워크플로를 어떻게 설계할 수 있을지 정리한 글이다. 모델별 실제 성능, 비용, 제한은 정식 공개와 API 문서 업데이트 이후 달라질 수 있다.
1. 문제의 배경
최근 AI 개발 도구의 흐름을 보면 공통점이 있다.
AI가 단순히 코드를 한 조각 추천하는 수준을 넘어, 점점 더 긴 작업을 맡기 시작했다.
예를 들어 요즘 개발자가 AI에게 맡기는 작업은 이런 식이다.
- GitHub 이슈를 읽고 원인 분석하기
- 관련 파일 검색하기
- 수정 계획 세우기
- 코드 변경하기
- 테스트 추가하기
- 테스트 실행 결과 요약하기
- PR 설명 작성하기
- 리뷰 코멘트 초안 만들기
이 흐름은 기존 자동완성 도구와 다르다.
자동완성 도구는 개발자가 작성 중인 코드 옆에서 보조한다.
에이전트형 도구는 목표를 받고, 여러 단계를 거쳐 작업을 수행한다.
GPT-5.6 발표에서 max, ultra, subagents 같은 표현이 중요한 이유도 여기에 있다.
개발 업무는 원래 한 번의 답변으로 끝나는 일이 아니다.
예를 들어 고객센터 AI 답변 추천 기능을 만든다고 해보자.
고객 문의를 입력하면 AI가 답변 초안을 추천하고,
상담사가 수정한 뒤 고객에게 보낼 수 있는 기능
이 기능을 제대로 만들려면 단순히 화면 하나를 만드는 것으로 끝나지 않는다.
- API 설계
- 프롬프트 설계
- 개인정보 로그 정책
- UI 상태 관리
- 에러 메시지 정책
- 테스트 데이터
- 평가 기준
- 운영 trace
- PR 설명
- 회귀 테스트
이런 작업은 여러 역할이 섞여 있다.
사람 팀이라면 기획자, 프론트엔드 개발자, 백엔드 개발자, QA, 보안 담당자, 리뷰어가 나눠서 본다.
AI 에이전트도 마찬가지다.
앞으로는 하나의 거대한 프롬프트보다, 작업을 역할별로 나누고 각 단계마다 검증하는 구조가 더 중요해질 가능성이 높다.
2. 왜 기존 방식으로는 부족한지
기존 AI 사용 방식은 대부분 채팅 중심이었다.
이 코드 설명해줘.
이 함수 고쳐줘.
이 에러 왜 나는지 봐줘.
테스트 코드 만들어줘.
이 방식은 여전히 유용하다.
작은 버그 수정, 문서 요약, 함수 단위 리팩토링에는 충분히 좋다.
하지만 실무 개발 업무는 보통 더 복잡하다.
예를 들어 로그인 실패 메시지를 수정한다고 해보자.
겉으로는 작은 작업처럼 보인다.
로그인 실패 시 서버 에러 메시지가 그대로 보이지 않게 수정해줘.하지만 실제로는 여러 기준을 확인해야 한다.
- 서버 에러 원문을 사용자에게 그대로 노출하면 안 된다.
- 네트워크 에러와 인증 실패를 구분해야 한다.
- ViewModel에서 직접 URLRequest를 만들면 안 된다.
- 에러 매핑 로직은 테스트되어야 한다.
- 기존 디자인 시스템은 건드리지 않아야 한다.
- 개인정보가 로그에 남으면 안 된다.
AI에게 단순히 “고쳐줘”라고만 하면 코드가 돌아갈 수는 있다.
하지만 팀의 아키텍처를 깨뜨릴 수 있고, 테스트 없이 완료했다고 말할 수 있고, 관련 없는 파일까지 수정할 수 있다.
그래서 고성능 모델이 나올수록 오히려 더 중요한 것은 “좋은 프롬프트”만이 아니다.
더 중요한 것은 좋은 작업 환경이다.
- 에이전트가 읽을 정책 파일
- 수정 가능한 파일 범위
- 실행 가능한 명령 목록
- 금지해야 할 작업
- 테스트 기준
- 사람 승인 기준
- 완료 보고 형식
GPT-5.6처럼 더 강한 모델이 나와도 이 원칙은 바뀌지 않는다.
모델이 강해질수록 더 많은 일을 맡길 수 있지만, 그만큼 통제와 검증도 중요해진다.
3. 개발자가 실제로 마주치는 문제
AI 에이전트를 실무에 넣으면 가장 먼저 이런 문제가 생긴다.
AI가 많이 고치긴 했는데, 이걸 믿고 머지해도 되나?이 불안감은 단순한 기분 문제가 아니다.
실제 개발 현장에서는 다음 문제가 자주 생긴다.
에이전트가 너무 많은 파일을 수정한다
간단한 에러 메시지 수정 요청을 했는데, 다음 파일들이 함께 바뀔 수 있다.
LoginView.swift
LoginViewModel.swift
AuthRepository.swift
NetworkClient.swift
ErrorMapper.swift
DesignSystemButton.swift
Localizable.strings
물론 필요한 경우도 있다.
하지만 리뷰어 입장에서는 부담이 커진다.
작은 문제를 고치는데 네트워크 계층, 디자인 시스템, 공통 컴포넌트까지 바뀌면 리뷰 난이도가 올라간다.
그래서 에이전트에게 작업 범위를 명확히 알려줘야 한다.
이번 작업은 로그인 실패 메시지 표시 로직만 수정한다.
DesignSystem, NetworkClient, 인증 API 구조는 바꾸지 않는다.
필요하다고 판단되면 먼저 이유를 설명하고 멈춘다.
강한 모델일수록 더 많은 가능성을 탐색한다.
그래서 실무에서는 “더 많이 고치는 능력”보다 “필요한 만큼만 고치는 능력”이 중요하다.
테스트를 실행하지 않고 완료했다고 말한다
AI가 만든 코드에서 가장 위험한 표현은 이것이다.
테스트가 통과할 것으로 보입니다.실무에서는 “보입니다”가 아니라 실행 결과가 필요하다.
완료 보고는 최소한 이렇게 나와야 한다.
실행한 명령:
npm test
npx playwright test
xcodebuild test
./gradlew test

결과:
통과 / 실패 / 실행 불가

실행하지 못한 이유:
환경 없음 / 의존성 없음 / 시뮬레이터 없음
테스트를 실제로 실행하지 않았다면, 실행하지 않았다고 말해야 한다.
테스트는 실행하지 못했습니다.
이유: 현재 환경에 Xcode 시뮬레이터가 없습니다.
권장 명령: xcodebuild test -scheme MyApp -destination 'platform=iOS Simulator,name=iPhone 16'
AI 에이전트가 더 똑똑해져도 검증 원칙은 바뀌지 않는다.
AI가 작성한 코드도 결국 빌드되어야 하고, 테스트되어야 하고, 사람이 리뷰할 수 있어야 한다.
에이전트가 팀의 개발 규칙을 모른다
개발자는 팀의 규칙을 배워서 알고 있다.
- ViewModel에서 직접 API 호출 금지
- 개인정보 원문 로그 금지
- 결제 관련 코드는 별도 승인 필요
- 운영 환경 설정 파일 수정 금지
- 신규 라이브러리 추가 전 승인 필요
- 테스트 없는 도메인 로직 수정 금지
하지만 에이전트는 이걸 자동으로 알지 못한다.
그래서 저장소 안에 에이전트용 정책 파일이 필요하다.
AGENTS.md
CLAUDE.md
.github/copilot-instructions.md
docs/ai/agent_policy.md
docs/ai/security_policy.md
docs/ai/test_policy.md
이 파일들은 사람을 위한 문서이기도 하지만, 동시에 에이전트가 따라야 할 작업 규칙이다.
GPT-5.6의 ultra처럼 subagents를 활용하는 방향이 중요해질수록, 이런 공통 규칙은 더 중요해진다.
여러 에이전트가 작업을 나눠도 같은 규칙을 따라야 하기 때문이다.
4. GPT-5.6 발표에서 개발자가 봐야 할 포인트
GPT-5.6 발표를 개발자 관점에서 보면 핵심은 네 가지다.
1. Sol / Terra / Luna로 역할이 나뉜다.
2. max reasoning effort가 추가됐다.
3. ultra mode가 subagents 기반 복잡한 작업을 겨냥한다.
4. 제한 프리뷰와 안전 검증이 함께 강조됐다.
Sol, Terra, Luna는 모델 라우팅의 힌트다
모델이 하나만 있는 시대는 지나가고 있다.
개발 워크플로에서는 작업마다 필요한 모델이 다르다.
예를 들어 자체 에이전트를 만든다면 모델을 이렇게 나눠 생각할 수 있다.
Sol:
- 복잡한 설계
- 장기 에이전트 작업
- 어려운 코드 분석
- 보안 리뷰
- 대규모 마이그레이션

Terra:
- 일반적인 기능 구현
- PR 리뷰
- 문서화
- 테스트 추가
- 일상적인 개발 업무

Luna:
- 빠른 요약
- 단순 분류
- 대량 처리
- 간단한 코드 변환
- 반복적인 자동화
이건 공식 매뉴얼 그대로의 사용법이라기보다, 발표된 모델 포지션을 개발팀 워크플로로 해석한 것이다.
핵심은 이거다.
모든 작업에 가장 강한 모델을 쓰는 방식은 점점 비효율적이 된다.앞으로 개발팀은 단순히 “어떤 모델이 가장 좋은가?”보다 “이 작업에는 어떤 모델이 적당한가?”를 고민해야 한다.
max reasoning effort는 깊은 분석 작업에 어울린다
max reasoning effort는 말 그대로 더 깊은 추론이 필요한 작업에 적합하다.
개발 업무에서는 이런 작업이 해당된다.
- 오래된 코드베이스 구조 분석
- 복잡한 장애 원인 추적
- 동시성 버그 분석
- 보안 취약점 리뷰
- 대규모 리팩토링 계획
- 여러 모듈에 걸친 마이그레이션
반대로 다음 작업에는 과할 수 있다.
- 버튼 문구 변경
- 간단한 DTO 필드 추가
- README 일부 수정
- 테스트 이름 변경
- 단순 if 조건 수정
실무 기준은 간단하다.
코드를 바로 고치면 되는 작업:
- 낮은 reasoning으로 충분

문제를 먼저 이해해야 하는 작업:
- 높은 reasoning이 필요

여러 단계로 나눠야 하는 작업:
- max 또는 ultra 고려
즉, max는 “항상 켜두는 고성능 옵션”이라기보다, 깊은 분석이 필요한 작업에 선택적으로 쓰는 카드로 보는 편이 좋다.
ultra mode는 자체 에이전트 설계와 연결된다
이번 발표에서 가장 흥미로운 부분은 ultra다.
ultra는 단일 에이전트가 모든 일을 혼자 처리하는 방식이 아니라, subagents를 활용해 복잡한 작업을 나눠 처리하는 방향으로 소개됐다.
개발자 입장에서 이건 중요한 힌트다.
실제 개발 업무도 원래 여러 역할로 나뉜다.
- 요구사항 분석자
- 코드 탐색자
- 구현자
- 테스트 작성자
- 보안 리뷰어
- 문서 작성자
- 최종 리뷰어
사람 팀에서는 이 역할을 여러 사람이 나눠서 한다.
에이전트 워크플로에서도 비슷한 구조를 만들 수 있다.
Planner Agent:
- 요구사항 정리
- 작업 범위 제한
- 파일 변경 계획 작성

Code Agent:
- 실제 코드 수정

Test Agent:
- 테스트 추가
- 테스트 실행 명령 제안

Review Agent:
- 위험한 변경 확인
- 보안/개인정보 정책 확인

Summary Agent:
- PR 설명 작성
- 변경 사항 요약
앞으로 에이전트 설계는 하나의 거대한 AI 호출보다, 역할을 나누고 각 역할의 책임을 제한하는 방향으로 발전할 가능성이 높다.
5. 자체 에이전트 설계 방식
GPT-5.6 같은 모델을 API나 사내 도구에 붙인다면, 단순히 모델 호출 함수 하나로 끝내면 안 된다.
자체 에이전트는 보통 다음 구조가 필요하다.
1. Planner
2. Tool Layer
3. Memory / Context
4. Policy
5. Evaluator
6. Reporter
폴더 구조로 보면 이렇게 잡을 수 있다.
ai-agent/
├── agents/
│   ├── planner.ts
│   ├── codeAgent.ts
│   ├── testAgent.ts
│   ├── reviewAgent.ts
│   └── reporterAgent.ts
├── tools/
│   ├── githubTool.ts
│   ├── fileSearchTool.ts
│   ├── shellTool.ts
│   └── ciTool.ts
├── policies/
│   ├── codingPolicy.md
│   ├── securityPolicy.md
│   └── testPolicy.md
├── evals/
│   ├── agentTasks.jsonl
│   └── runAgentEval.ts
├── traces/
│   └── traceWriter.ts
└── workflows/
    ├── fixBug.workflow.ts
    ├── reviewPR.workflow.ts
    └── addFeature.workflow.ts
핵심은 에이전트를 하나의 거대한 모델 호출로 만들지 않는 것이다.
좋은 에이전트는 역할이 나뉘어 있어야 한다.
정책 파일 예시
# policies/codingPolicy.md

## Goal

The coding agent should make small, reviewable changes.

## Rules

- Prefer small diffs.
- Do not rewrite unrelated files.
- Do not introduce new dependencies without approval.
- Do not modify production configuration.
- Do not claim tests passed unless they were actually executed.
- If more than 5 files need to be changed, stop and explain the plan first.

## Architecture

- Presentation layer must not call external APIs directly.
- Network calls must go through Repository.
- Business logic should live in UseCase or Domain layer.
- UI state should be isolated from background processing.

## Completion Format

The agent must report:

## Summary

- What changed

## Files Changed

- List modified files

## Validation

- Commands executed
- Result
- If not executed, explain why

## Risk

- Possible side effects
- Human review needed
이런 정책이 있어야 모델이 바뀌어도 작업 품질을 어느 정도 유지할 수 있다.
모델 성능은 계속 바뀐다.
하지만 팀의 개발 기준은 저장소 안에 남아 있어야 한다.
간단한 agent workflow 예시
type AgentTask = {

  title: string;

  description: string;

  riskLevel: "low" | "medium" | "high";

};

type AgentPlan = {

  summary: string;

  filesToInspect: string[];

  steps: string[];

  testsToRun: string[];

  needsHumanApproval: boolean;

};

async function planTask(task: AgentTask): Promise<AgentPlan> {

  if (task.riskLevel === "high") {

    return {

      summary: "High-risk task. Plan only before editing.",

      filesToInspect: [],

      steps: [

        "Read project policy",

        "Inspect related files",

        "Prepare implementation plan",

        "Ask for human approval before editing"

      ],

      testsToRun: [],

      needsHumanApproval: true

    };

  }

  return {

    summary: "Low or medium-risk task. Proceed with small diff.",

    filesToInspect: [],

    steps: [

      "Read related files",

      "Make minimal changes",

      "Run relevant tests",

      "Report result"

    ],

    testsToRun: ["npm test"],

    needsHumanApproval: false

  };

}
실제 모델 호출은 여기에 붙이면 된다.
중요한 것은 모델에게 바로 “고쳐줘”라고 하지 않는 것이다.
먼저 작업 위험도를 나누고, 고위험 작업은 계획 단계에서 멈추게 해야 한다.
모델 라우팅 예시
GPT-5.6처럼 모델 계층이 나뉘면, 자체 에이전트에서도 모델 라우팅이 필요하다.
type ModelTier = "sol" | "terra" | "luna";

type TaskKind =
  | "summarize"
  | "classify"
  | "code_change"
  | "security_review"
  | "migration"
  | "test_generation";

type RoutedTask = {
  kind: TaskKind;
  riskLevel: "low" | "medium" | "high";
};

function selectModel(task: RoutedTask): ModelTier {
  if (task.riskLevel === "high") {
    return "sol";
  }

  if (task.kind === "security_review" || task.kind === "migration") {
    return "sol";
  }

  if (task.kind === "summarize" || task.kind === "classify") {
    return "luna";
  }

  return "terra";
}
이 예시는 실제 API 스펙이 아니라 워크플로 설계 예시다.
현실적인 운영 기준은 이렇게 잡을 수 있다.
Luna:
- 빠른 분류
- 로그 요약
- 단순 문서 변환
- 반복 작업

Terra:
- 일반 코드 수정
- 테스트 추가
- PR 설명
- 문서화

Sol:
- 설계
- 보안 리뷰
- 복잡한 디버깅
- 대규모 마이그레이션
- 최종 검토
이렇게 나누면 모든 작업을 가장 강한 모델에 태우지 않아도 된다.
6. 성능 리뷰: 기대할 점과 조심할 점
GPT-5.6 발표를 개발자 관점에서 보면 기대되는 부분은 분명하다.
기대할 점
첫째, 장기 작업에 더 강해지는 방향이다.
코딩 에이전트에서 중요한 것은 단순 코드 생성이 아니다.
- 계획 세우기
- 파일 탐색
- 도구 호출
- 테스트 실행
- 실패 후 재시도
- 변경 요약
이런 작업은 한 번의 답변보다 여러 단계의 실행 능력이 중요하다.
GPT-5.6 Sol은 이런 장기 agentic workflow 쪽을 강조하고 있다.
둘째, 모델 선택지가 더 명확해졌다.
Sol, Terra, Luna처럼 모델을 역할별로 나누면 개발팀은 작업 난이도에 따라 모델을 선택할 수 있다.
셋째, subagent 기반 작업이 공식 흐름으로 들어왔다.
이건 자체 에이전트를 만드는 팀에게 큰 힌트다.
앞으로 에이전트 설계는 단일 모델 호출보다 역할 분담 구조가 중요해질 가능성이 높다.
조심할 점
하지만 과하게 기대하면 안 되는 부분도 있다.
첫째, 제한 프리뷰다.
초기에는 제한된 파트너나 승인된 사용자 중심으로 제공될 수 있다. 실제 제품 적용은 공개 범위, API 제공 방식, 사용 제한을 확인해야 한다.
둘째, 벤치마크는 실서비스 품질을 보장하지 않는다.
코딩 벤치마크에서 좋아졌다고 해서 우리 회사 코드베이스에서 바로 좋은 PR을 만든다는 뜻은 아니다.
실제 서비스에서는 다음이 더 중요하다.
- 우리 아키텍처를 지키는가
- 테스트를 실행하는가
- 보안 정책을 지키는가
- 개인정보를 로그에 남기지 않는가
- 리뷰 가능한 작은 diff를 만드는가
셋째, 강한 에이전트일수록 강한 통제가 필요하다.
강한 모델은 더 많은 일을 할 수 있다.
하지만 더 많은 일을 할 수 있다는 것은, 잘못된 방향으로 더 많은 변경을 만들 수도 있다는 뜻이다.
강한 에이전트에는 반드시 이런 장치가 필요하다.
- 작업 범위 제한
- 금지 파일 목록
- 실행 가능한 명령 allowlist
- production 명령 차단
- 테스트 실행 결과 요구
- human approval gate
- trace와 audit log
7. 팀 단위로 적용하는 방법
GPT-5.6이나 자체 에이전트를 팀에 도입하려면 한 번에 크게 바꾸지 않는 것이 좋다.
현실적인 순서는 다음과 같다.
1단계: AI에게 맡길 작업을 분류한다
먼저 작업을 세 단계로 나눈다.
Low Risk:
- 문서 요약
- PR 설명 작성
- 간단한 테스트 추가
- 작은 UI 문구 수정

Medium Risk:
- 버그 수정
- ViewModel 리팩토링
- API 응답 매핑 수정
- 테스트 구조 개선

High Risk:
- 인증
- 결제
- 개인정보
- 보안
- DB 마이그레이션
- 배포 파이프라인
- 대규모 아키텍처 변경
Low Risk는 에이전트가 바로 작업해도 된다.
Medium Risk는 계획 후 작업한다.
High Risk는 계획만 작성하고 사람 승인 후 진행한다.
2단계: 정책 파일을 만든다
저장소 루트에 AGENTS.md를 둔다.
# AGENTS.md

## Project Rules

- Keep changes small and reviewable.
- Follow existing architecture.
- Do not modify production configuration.
- Do not introduce new dependencies without approval.
- Do not log sensitive user data.
- Do not run deployment commands.
- Do not claim tests passed unless executed.

## Risk Policy

High-risk areas require human approval before editing:

- Authentication
- Payment
- Privacy
- Security
- Database migration
- Production deployment
- CI/CD secrets

## Validation

After changes, report:

- Modified files
- Commands executed
- Test result
- Not executed tests and reason
- Remaining risks
이 문서는 단순 문서가 아니다.
에이전트가 프로젝트에서 일하는 규칙이다.
3단계: 자체 에이전트는 처음부터 모든 권한을 주지 않는다
처음에는 읽기 전용부터 시작하는 게 좋다.
1단계:
- PR 분석
- 로그 요약
- 테스트 실패 원인 분류

2단계:
- 테스트 코드 초안 작성
- 작은 버그 수정
- 문서 업데이트

3단계:
- 제한된 파일 범위 내 코드 수정
- CI 실행
- PR 설명 작성

4단계:
- 사람 승인 후 복잡한 작업 수행
에이전트는 권한 설계가 핵심이다.
성능 좋은 모델을 붙였다고 바로 shell, GitHub write, 배포 권한을 모두 주면 위험하다.
4단계: 에이전트 결과를 평가한다
자체 에이전트도 eval이 필요하다.
예를 들어 이런 평가 데이터를 만들 수 있다.
{"id":"agent-001","task":"로그인 실패 메시지 수정","expected":["에러 매핑 수정","테스트 추가","NetworkClient 미수정"],"forbidden":["운영 설정 수정","DesignSystem 대규모 변경"]}
{"id":"agent-002","task":"고객센터 AI 답변 추천 PR 리뷰","expected":["개인정보 로그 확인","에러 처리 확인","테스트 누락 확인"],"forbidden":["취향 기반 코멘트만 남김"]}
평가 기준은 단순하다.
- 요구사항을 지켰는가
- 불필요한 파일을 수정하지 않았는가
- 테스트를 실행했는가
- 금지된 작업을 하지 않았는가
- 사람 리뷰가 쉬운 결과를 만들었는가
AI 에이전트는 만들고 끝이 아니다.
계속 평가하고 개선해야 한다.
8. 마무리
GPT-5.6 발표는 단순히 “더 강한 모델이 나왔다”로만 보면 아쉽다.
개발자가 봐야 할 핵심은 더 크다.
AI 사용 방식이 채팅에서 에이전트로 이동하고 있다.
Sol, Terra, Luna는 작업 난이도에 따른 모델 선택을 보여준다.
max reasoning은 깊은 분석 작업을 겨냥한다.
ultra mode는 subagents 기반 복잡한 작업 분해를 가리킨다.
에이전트형 AI는 업무 단위를 단일 질문에서 장기 위임 작업으로 바꾸고 있다.
한국 개발자들이 이 주제를 알아야 하는 이유도 분명하다.
앞으로 개발팀은 단순히 AI에게 코드를 물어보는 수준을 넘어서게 된다.
- 어떤 작업을 AI에게 맡길지
- 어떤 모델을 쓸지
- 어떤 권한을 줄지
- 어떤 정책 파일을 읽게 할지
- 어떤 테스트를 실행하게 할지
- 어떤 단계에서 사람 승인을 받을지
- 실패 결과를 어떻게 추적할지
이걸 설계해야 한다.
GPT-5.6 같은 모델은 더 많은 일을 할 수 있게 해준다.
하지만 더 많은 일을 할 수 있다는 것은, 더 많은 사고를 낼 수도 있다는 뜻이다.
그래서 앞으로 중요한 개발 역량은 “AI에게 질문을 잘하는 능력”에서 “AI 에이전트가 안전하게 일할 수 있는 시스템을 설계하는 능력”으로 이동할 가능성이 높다.
모델은 계속 강해진다.
하지만 좋은 개발팀은 모델만 기다리지 않는다.
모델이 들어와도 흔들리지 않는 작업 규칙, 테스트, 권한, 평가 구조를 만든다.
GPT-5.6 시대의 핵심은 결국 이것이다.
더 똑똑한 모델보다,
더 잘 통제되는 에이전트 워크플로가 중요하다.
참고 자료
- OpenAI: Previewing GPT-5.6 Sol
- OpenAI Help Center: A preview of GPT-5.6 Sol, Terra, and Luna
- OpenAI Developer Community: Introducing GPT-5.6 series
- OpenAI: How agents are transforming work
- OpenAI: A practical guide to building AI agents
'IT' 카테고리의 다른 글
| AI Agent Runtime의 다음 진화: Stateless Core + Stateful Application 아키텍처 (1) | 2026.07.18 |
|---|---|
| AI 에이전트가 어제 한 일을 잊지 않게 만드는 법: Durable Memory와 Run Ledger 설계 (1) | 2026.07.18 |
| 최근 AI 새 버전들이 진짜로 밀고 있는 기술: 모델보다 중요한 Agent Runtime 설계 (1) | 2026.07.18 |
| AI 코딩 에이전트 성능을 확 올리는 실전 스킬: Context Pack 만들기 (0) | 2026.07.18 |
| iOS 앱에 AI를 붙일 때, 이제 서버부터 생각하면 늦다 - 온디바이스 LLM (1) | 2026.07.18 |