GPT-6와 Claude 5.5, 이제 토큰보다 캐시가 중요하다
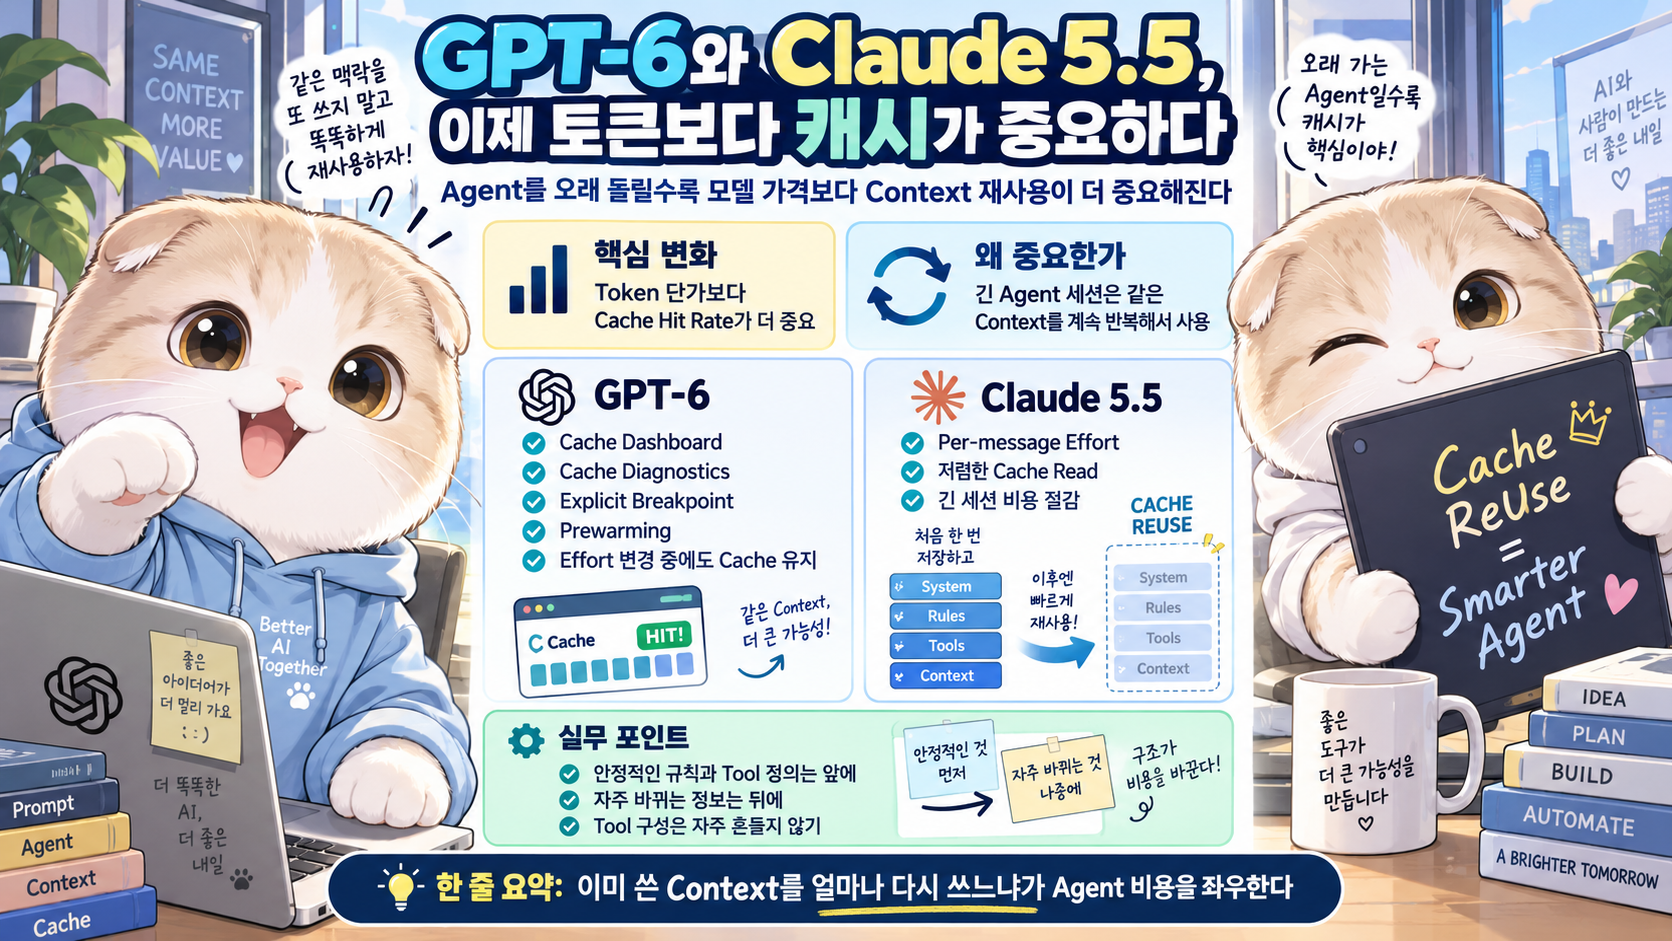
Agent를 오래 돌릴수록 모델 가격보다 Context를 얼마나 다시 쓰느냐가 중요해지는 이유
AI 모델 가격을 비교할 때 보통 가장 먼저 보는 숫자는 이겁니다.
Input Token 가격
Output Token 가격
짧은 질문을 한두 번 하는 정도라면 이것만 봐도 충분합니다.
하지만 Codex나 Claude Code처럼 Agent가 한 작업을 오래 이어가면 이야기가 달라집니다.
Agent는 매번 새 질문 하나만 보내는 게 아닙니다.
프로젝트 규칙, Tool 정의, 이전 대화, 코드, Build 결과처럼 이미 한 번 읽었던 내용을 계속 가지고 다음 작업을 이어갑니다.
AGENTS.md / CLAUDE.md

Tool Definitions

Repository Context

Conversation History

Build / Test Result

현재 작업 내용
Context가 10만, 20만 Token까지 커진 상태에서 매 요청마다 이 내용을 처음부터 다시 계산한다면 비용도 커지고 응답도 느려집니다.
그래서 최근 GPT-6와 Claude Opus 5.5를 보면 공통적으로 눈에 들어오는 것이 Prompt Cache입니다.
GPT-6는 Cache Hit를 높이고 어디서 Cache가 깨졌는지 확인하는 기능까지 크게 늘렸고, Claude는 긴 Session에서 Effort를 바꾸면서도 Cache를 유지하는 방법을 제공하고 있습니다.
1. Prompt Cache가 뭐길래 중요해졌을까
쉽게 생각하면 됩니다.
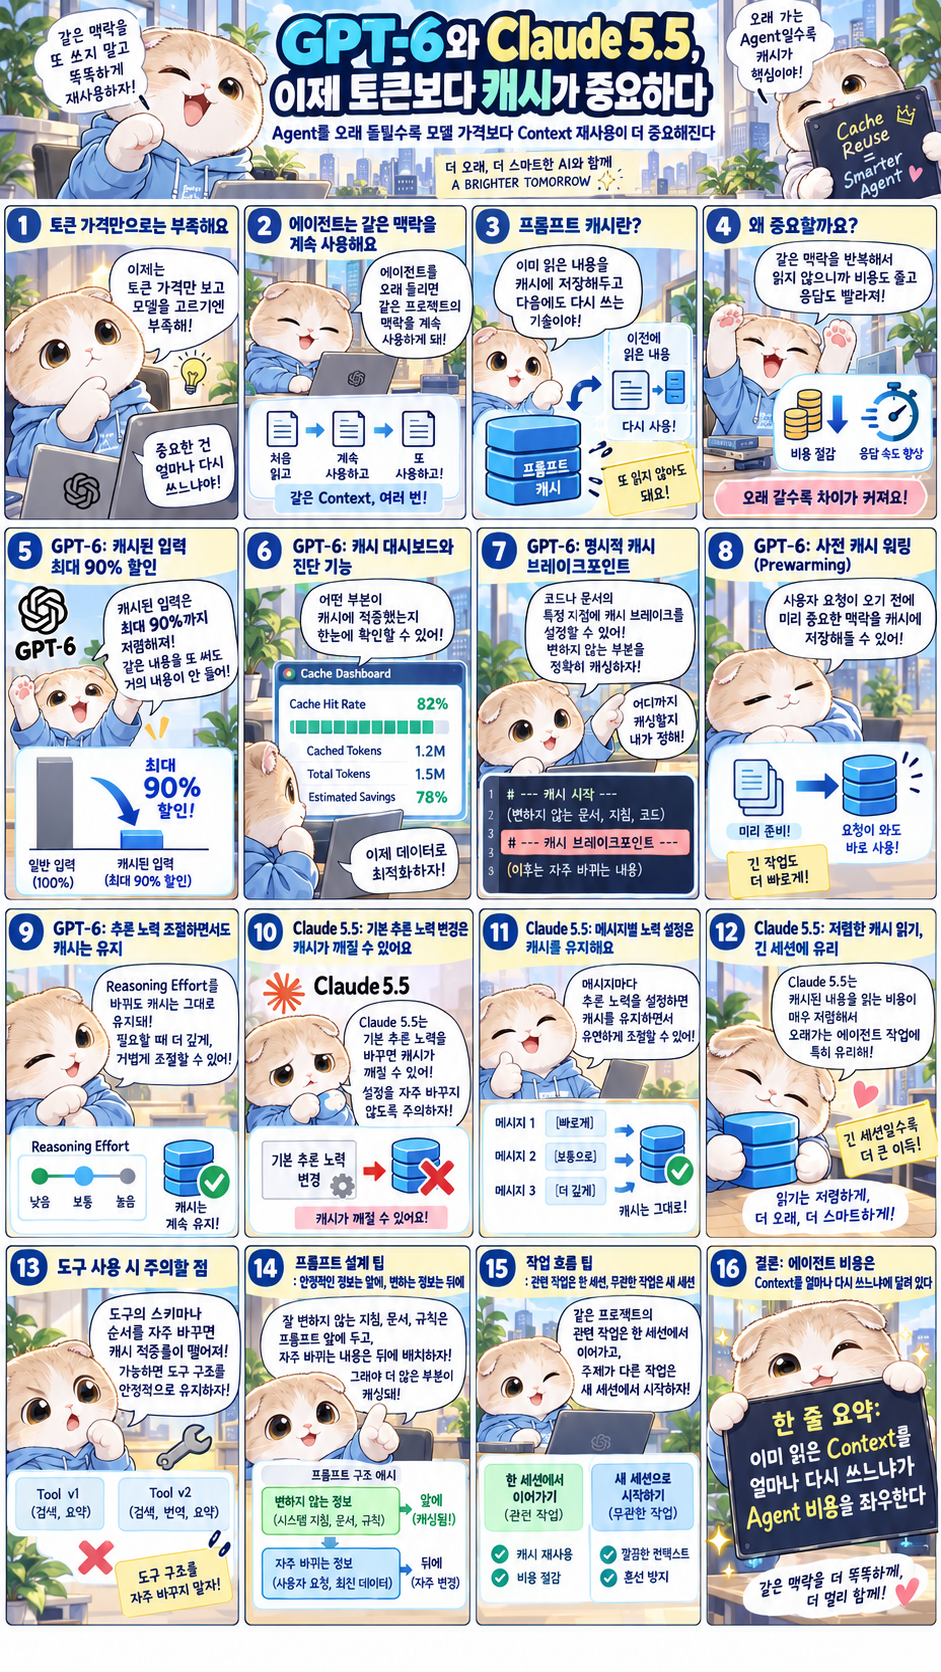
Agent가 이미 읽은 내용 중 변하지 않은 부분을 매번 처음부터 다시 처리하지 않는 것입니다.
첫 요청이:
System Instructions

AGENTS.md

20개의 Tool 정의

Repository 설명

사용자 질문 A
였다면,
다음 요청은 보통:
System Instructions        ← 그대로

AGENTS.md                  ← 그대로

20개의 Tool 정의          ← 그대로

Repository 설명           ← 그대로

사용자 질문 A             ← 그대로

Agent 답변                 ← 추가

사용자 질문 B             ← 추가
가 됩니다.
앞부분 대부분은 이미 처리한 내용입니다.
Cache가 잘 유지되고 있다면 모델은 이 긴 앞부분을 그대로 재사용하고 새롭게 추가된 부분만 처리하면 됩니다.
그래서 긴 Agent Session에서는:
전체 Context 크기만큼이나
그중 얼마나 Cache로 다시 읽었는가가 중요해집니다.
2. Agent에서는 같은 Context를 계속 반복해서 쓴다
일반 Chat에서는 질문 하나 하고 끝날 수 있습니다.
하지만 Coding Agent는 그렇지 않습니다.
예를 들어 버그 하나를 고친다고 해보겠습니다.
Repository 분석

→ 관련 파일 검색

→ 코드 읽기

→ 수정

→ Build

→ Test 실패

→ Log 확인

→ 다시 코드 수정

→ Test

→ Review
10번의 Model Call이 발생해도 프로젝트 설명이나 Tool 정의 대부분은 그대로입니다.
그래서 매번:
100K Context × 10번을 전부 새로 처리하는 것과,
처음 한 번 처리한 100K를 이후 요청에서 대부분 Cache로 재사용하는 것은 비용 차이가 큽니다.
이 때문에 Agent가 길게 일할수록 Prompt Cache의 가치가 커집니다.
GPT-6에서 Cache가 꽤 많이 바뀌었다
3. GPT-6는 Cached Input을 최대 90% 할인한다
OpenAI는 GPT-6와 함께 Prompt Caching을 크게 손봤습니다.
공식 설명 기준으로 동일한 Prompt Prefix를 다시 사용하는 경우 Cached Input Token은 최대 90% 할인을 받을 수 있습니다.
또 GPT-6 계열에서는 재사용 가능한 Prefix가 30분 동안 유지될 수 있도록 Cache 동작도 개선됐습니다.
Agent 입장에서는 꽤 큰 차이입니다.
예를 들어:
공통 Instructions
Tool Schema
프로젝트 규칙
긴 대화 Context
같은 부분이 계속 Cache에 걸린다면 매 Turn마다 Fresh Input 가격을 전부 지불하지 않아도 됩니다.
4. GPT-6에서는 Cache가 왜 깨졌는지도 볼 수 있다
예전 Prompt Cache의 불편한 점 중 하나는:
왜 이번에는 Cache Hit가 안 됐지?
를 알아내기 어렵다는 것이었습니다.
GPT-6에서는 이 부분에 관리 기능이 추가됐습니다.
Prompt Caching Dashboard
전체 요청 중:
Cached Input

Uncached Input
비율을 볼 수 있습니다.
Cache Diagnostics
Cache가 깨졌다면:
Tool이 변경됨

Model이 변경됨

설정이 변경됨

Prompt Prefix가 달라짐
같은 이유를 확인할 수 있습니다.
즉 이제 Prompt Cache가 단순한 내부 최적화가 아니라 개발자가 직접 관리하는 성능 지표에 가까워졌습니다.
5. 원하는 지점까지 직접 Cache할 수도 있다
GPT-6에서는 Explicit Cache Breakpoint도 사용할 수 있습니다.
예를 들어 Agent Prompt가:
공통 Agent 규칙

프로젝트 Architecture

Tool Definitions

현재 사용자 정보

현재 시간

이번 요청
순서라면,
앞의 안정적인 부분까지만 Cache 대상으로 잡을 수 있습니다.
공통 Agent 규칙

프로젝트 Architecture

Tool Definitions

──────── Cache Breakpoint ────────

현재 사용자 정보

현재 시간

이번 요청
자주 바뀌는 정보를 Cache 뒤쪽에 두는 방식입니다.
이렇게 하면 매 요청마다 바뀌는 정보 때문에 앞의 긴 Context까지 다시 처리하는 문제를 줄일 수 있습니다.
6. Cache를 미리 데워두는 것도 가능하다
GPT-6에는 Cache Prewarming도 있습니다.
사용자가 질문하기 전에:
공통 Instructions

Tool Definitions

Reference Document
처럼 미리 알고 있는 Context를 먼저 Cache에 올려두는 방식입니다.
그러면 실제 사용자 요청이 들어왔을 때 긴 공통 Context를 처리하는 시간이 사용자 대기시간에 포함되지 않을 수 있습니다.
예를 들어 사내 Agent라면:
서비스 시작

↓

회사 공통 규칙
Tool Schema
제품 문서

Cache Prewarm

↓

사용자 첫 질문
처럼 구성할 수 있습니다.
특히 첫 응답 속도가 중요한 서비스에서는 꽤 실용적인 기능입니다.
이번 GPT-6 변화에서 특히 재미있는 부분
7. Reasoning Effort를 바꿔도 Cache를 유지할 수 있다
Agent를 쓰다 보면 모든 작업의 난이도가 같지 않습니다.
예를 들어:
파일 이름 변경
→ 낮은 Effort

일반 Feature 구현
→ Medium

복잡한 Concurrency Bug
→ High
처럼 쓰고 싶습니다.
문제는 Reasoning 설정을 바꾸면서 Prompt 자체가 달라지면 Cache가 깨질 수 있다는 점입니다.
GPT-6에서는 configuration_update를 Conversation 뒤에 추가하는 방식으로 기존 Context는 그대로 유지하면서 이후 작업의 Reasoning Effort만 변경할 수 있습니다.
구조는 대략 이렇습니다.
긴 기존 Context
───────────────

Medium으로 작업

↓

어려운 문제 등장

↓

configuration_update
effort = high

↓

기존 Cache 유지

↓

작업 계속
이게 긴 Agent Session에서는 꽤 중요합니다.
Claude 5.5도 비슷한 방향으로 움직이고 있다
8. Claude도 Top-level Effort를 바꾸면 Cache가 깨진다
Claude Opus 5.5에서도 Effort는 중요한 비용 조절 수단입니다.
기본값은:
medium입니다.
그런데 API 요청의 Top-level Effort를:
medium
→
high
로 바꾸면 Prompt Cache가 다시 시작됩니다.
긴 Context를 사용하고 있었다면 앞의 Context를 다시 Cache Write해야 할 수 있습니다.
그래서 긴 Agent Conversation에서 Effort를 계속 바꾸는 것은 생각보다 비용이 들 수 있습니다.
9. Claude에는 Per-message Effort가 있다
이 문제를 해결하기 위한 기능이 Per-message Effort입니다.
예를 들어:
일반 Coding
Medium

↓

이번 Turn만 어려움
High

↓

다음 Turn
다시 Medium
처럼 특정 Turn의 Effort만 바꿀 수 있습니다.
이 방식을 사용하면 앞의 Prompt Cache를 그대로 유지할 수 있습니다.
현재 Beta 기능이며 Claude Opus 5.5도 지원합니다.
즉 GPT-6과 Claude 5.5 모두 결국 비슷한 문제를 해결하고 있습니다.
Context는 그대로 두고

↓

이번 작업의 Reasoning 깊이만 바꾸기
입니다.
10. Claude 5.5에서는 Cache Read 가격도 상당히 낮다
Opus 5.5 API 가격은:
Fresh Input
$4 / MTok

5분 Cache Write
$5 / MTok

Cache Read
$0.20 / MTok
입니다.
Cache Read는 Fresh Input의 5% 수준입니다.
그래서 긴 Context를 반복해서 사용하는 Agent라면:
모델 Input 가격만 보는 것보다
실제로 Fresh Input으로 처리된 양

vs

Cache에서 읽은 양
을 같이 봐야 합니다.
Tool이 많아질수록 Cache 관리도 어려워진다
11. Tool Schema 하나 바꿔도 Cache가 영향을 받을 수 있다
Coding Agent에는 Tool이 많습니다.
GitHub

Search

Terminal

Browser

Database

Xcode

Simulator
등이 있습니다.
그리고 Tool마다 긴 Schema와 설명이 들어갑니다.
이 Tool 정의 역시 Prompt의 일부입니다.
따라서 매 요청마다:
Tool 1
Tool 2
Tool 3
순서를 바꾸거나,
Tool 설명을 수정하거나,
Schema를 조금씩 다르게 만들면 기존 Prefix와 달라질 수 있습니다.
결국 Cache Hit가 떨어집니다.
12. GPT-6는 Tool을 지우지 말고 사용 가능 여부만 바꾸는 방식을 권장한다
예를 들어 이번 Turn에서는 GitHub Tool이 필요 없다고 해보겠습니다.
매번 Tool 목록에서 GitHub를 제거하면:
이전 Prompt

Tool A
Tool B
Tool C

↓

새 Prompt

Tool A
Tool C
가 되면서 앞의 Context가 달라질 수 있습니다.
GPT-6에서는 Tool 정의 자체는 그대로 유지하고:
allowed_tools로 이번 요청에서 사용할 Tool만 제한하거나,
필요 없다면:
tool_choice = none으로 두는 방법을 권장합니다.
핵심은:
안 쓰는 Tool을 삭제하지 말고 Tool 목록 자체는 가능한 한 안정적으로 유지하는 것입니다.
그래서 Agent Prompt 구조도 달라져야 한다
13. 변하지 않는 것은 앞에, 자주 바뀌는 것은 뒤에 둔다
Prompt Cache는 앞에서부터 동일한 Prefix를 찾습니다.
그래서 Agent Prompt가 이런 식이라면:
현재 시간

사용자별 설정

AGENTS.md

Tool Schema

Architecture

이번 질문
좋지 않을 수 있습니다.
맨 앞의 시간이 매번 바뀌기 때문입니다.
오히려:
AGENTS.md

Architecture

Tool Schema

공통 Reference

──────── 안정적인 Context ────────

사용자별 정보

현재 시간

이번 질문
처럼 배치하는 것이 유리합니다.
원칙은 간단합니다.
잘 안 바뀌는 정보는 앞쪽. 자주 바뀌는 정보는 뒤쪽.
14. AGENTS.md와 CLAUDE.md도 Cache 관점에서 볼 필요가 있다
예전에는 AGENTS.md나 CLAUDE.md를:
Agent에게 프로젝트 규칙을 알려주는 문서
정도로 생각했습니다.
Cache까지 생각하면 한 가지 이유가 더 생깁니다.
프로젝트 규칙을 안정적인 한 곳에 두면:
매 요청마다 달라지는 Prompt보다 훨씬 재사용하기 쉽습니다.
예를 들어:
Architecture Rule

Build 명령

Test 명령

파일 구조

금지된 Dependency
같은 내용은 자주 바뀌지 않습니다.
이런 Context는 Prompt 앞쪽에서 안정적으로 유지하는 것이 좋습니다.
Cache를 깨는 흔한 패턴
15. Agent를 만들 때 이런 부분을 주의할 만하다
System Prompt를 매번 새로 생성
현재 날짜를 System Prompt 첫 줄에 넣기처럼 Dynamic 값이 앞부분에 들어가면 재사용하기 어렵습니다.
Tool 순서를 계속 변경
같은 Tool이라도 정의 순서가 달라지면 Prompt가 달라질 수 있습니다.
Tool Schema를 매 Turn 수정
사용하지 않는 Tool을 삭제했다 다시 추가하는 식도 좋지 않습니다.
Conversation History를 다시 작성
이전 대화를 그대로 이어붙이는 대신 매번 요약해서 새 Prompt로 만들면 Prefix가 달라질 수 있습니다.
Reasoning Effort를 Top-level에서 계속 변경
GPT-6과 지원되는 Claude 모델 모두 Cache를 보존하는 별도 방식을 사용하는 편이 좋습니다.
너무 잦은 Compaction
Compaction은 Context를 줄여주지만 이전 Prefix가 달라지기 때문에 Cache Hit가 줄 수 있습니다.
즉 Context를 줄이는 것과 Cache를 유지하는 것 사이에도 균형이 필요합니다.
Cache가 얼마나 중요하냐면
16. OpenAI가 공개한 실제 사례도 꽤 크다
OpenAI가 공개한 한 고객 사례에서는 Explicit Cache Breakpoint를 적용한 뒤 평가 환경의 Cache Hit Rate가:
83%
→
91%
로 올라갔습니다.
그 결과 Cache Write는 약 3분의 2 줄었고, 같은 작업량에서 Inference 비용은 36% 감소했다고 합니다.
물론 특정 서비스 사례라 모든 Agent가 36% 절감된다는 뜻은 아닙니다.
중요한 부분은:
모델을 바꾸지 않았는데도 Cache 관리만으로 비용이 크게 달라질 수 있다.
는 점입니다.
GPT-6과 Claude 5.5를 비교하면
17. 둘 다 Cache가 중요하지만 접근법은 조금 다르다
| 항목 | GPT-6 | Claude Opus 5.5 |
|---|---|---|
| 자동 Prompt Cache | 지원 | 지원 |
| Effort 변경 + Cache 유지 | configuration_update |
Per-message Effort |
| Cache 관리 Dashboard | 지원 | 상대적으로 제한적 |
| Cache Miss 진단 | 지원 | 별도 관리 필요 |
| Explicit Breakpoint | 지원 | Prompt Cache 지점 지정 방식 지원 |
| Prewarming | 지원 | 일반적인 Cache Write 방식 활용 |
| Cached Input 절감 | 최대 90% | Cache Read $0.20 / MTok |
| 긴 Agent Session | 매우 중요 | 매우 중요 |
둘 중 누가 Cache 자체를 더 잘한다고 단순하게 말하기보다는 차이가 있습니다.
GPT-6는 이번 업데이트에서 Cache를 눈으로 보고 직접 튜닝하는 운영 도구가 많이 추가됐습니다.
Claude 5.5는 저렴한 Cache Read와 Effort 조절을 긴 Agent Session에 활용하는 방식이 눈에 띕니다.
Codex나 Claude Code를 실제로 쓴다면
18. 일반 개발자는 Cache를 직접 코딩하지 않아도 된다
API를 직접 만드는 개발자가 아니라면:
prompt_cache_breakpoint

configuration_update

output_config
같은 API를 매일 만질 필요는 없습니다.
그래도 Cache가 어떻게 동작하는지 알고 있으면 Agent를 훨씬 효율적으로 사용할 수 있습니다.
예를 들어 긴 Claude Code Session에서 별 이유 없이:
Medium

High

Medium

High
를 계속 오가는 것은 좋지 않을 수 있습니다.
작업 경계에 맞춰 Effort를 바꾸는 편이 낫습니다.
Codex 역시 Agent Context나 Tool 구성을 필요 없이 계속 바꾸는 것보다 안정적으로 유지하는 편이 Cache에 유리합니다.
19. 새 Session을 계속 만드는 것도 비용 측면에서는 생각해볼 문제다
예를 들어 같은 Feature를 작업하면서:
Session A
→ 조사

Session B
→ 구현

Session C
→ 테스트

Session D
→ 수정
처럼 계속 새 Session을 만들면 각 Session에서 프로젝트 Context를 다시 읽어야 할 수 있습니다.
반대로 하나의 Session에서 너무 오래 작업하면 Context 자체가 너무 커집니다.
그래서 실제로는:
하나의 관련 작업
→ 같은 Session

업무 주제가 완전히 달라짐
→ 새 Session
정도가 자연스럽습니다.
Cache 때문에 모든 작업을 한 Session에 몰아넣을 필요도 없습니다.
결국 Agent 비용은 이렇게 보는 게 더 맞다
20. 이제는 Token 단가 하나로 비교하기 어렵다
Agent의 실제 비용은 대략 이런 요소가 합쳐집니다.
Fresh Input

+

Cache Write

+

Cache Read

+

Thinking

+

Output

+

Tool Call

+

Retry
그리고 가장 비싼 Agent가 항상 가장 비싼 것도 아닙니다.
비싼 모델이 한 번에 끝내고,
싼 모델이 다섯 번 실패한다면 결과가 달라질 수 있습니다.
반대로 높은 Effort가 필요 없는 작업에 계속 가장 깊은 Reasoning을 사용해도 낭비입니다.
그래서 앞으로 Agent 비용을 볼 때는:
가격표뿐 아니라:
Cache Hit Rate

Task당 Turn 수

Thinking 사용량

Retry 횟수
까지 같이 봐야 합니다.
21. 실무에서는 이렇게 시작하면 된다
Agent API를 직접 만든다면 우선 네 가지부터 보면 됩니다.
1. Stable Context를 앞에 둔다
System Rule
Architecture
Tool Schema
공통 Reference
2. Dynamic Context는 뒤에 둔다
현재 시간
사용자 정보
이번 요청
3. Tool 정의를 자주 바꾸지 않는다
필요한 Tool만 활성화하는 방식을 사용합니다.
4. Cache Hit Rate를 실제로 측정한다
추측보다 실제 데이터가 중요합니다.
GPT-6를 사용한다면 새 Cache Dashboard와 Diagnostics가 이 부분에 특히 유용합니다.
마치며
GPT-6와 Claude Opus 5.5를 보면 모델 경쟁의 기준이 조금씩 바뀌는 것이 보입니다.
예전에는:
누가 더 똑똑한가?

누가 Token 가격이 싼가?
가 중요했습니다.
Agent가 길게 일하기 시작하면서 이제는 질문이 하나 더 생겼습니다.
이미 읽은 Context를
얼마나 다시 활용할 수 있는가?
입니다.
특히 Coding Agent는 같은 프로젝트 규칙과 Tool, Repository Context를 여러 Turn에 걸쳐 계속 사용합니다.
그런 환경에서는:
비싼 Context를 매번 다시 읽는 Agent와
한 번 읽은 Context를 계속 Cache로 재사용하는 Agent의 실제 운영비가 크게 달라질 수 있습니다.
GPT-6는 이번에 Cache Dashboard, Miss Diagnostics, Explicit Breakpoint, Prewarming까지 추가하면서 Prompt Cache를 개발자가 직접 관리하는 영역으로 끌어올렸습니다.
Claude Opus 5.5도 Per-message Effort를 이용하면 긴 Context를 그대로 유지하면서 특정 Turn에서만 더 깊게 생각하게 할 수 있습니다.
그래서 앞으로 Agent를 만들 때는 모델 선택만큼:
Context를 어떻게 배치하고, 어디까지 Cache하고, 무엇 때문에 Cache가 깨지는지를 설계하는 것도 중요해질 가능성이 큽니다.
한 줄로 줄이면 이렇습니다.
Agent 시대에는 Token을 얼마나 쓰느냐보다, 이미 쓴 Token을 얼마나 다시 쓰느냐가 점점 중요해지고 있습니다.
참고자료
OpenAI — Better prompt caching for GPT-6
GPT-6에서 새롭게 추가된 Prompt Caching Dashboard, Cache Miss Diagnostics, Explicit Cache Breakpoint, Prewarming과 Reasoning Effort 변경 시 Cache를 유지하는 방법을 설명한 공식 발표입니다.
OpenAI API — Prompt Caching
Prompt Prefix가 어떻게 Cache되는지, Cache Breakpoint와 configuration_update, allowed_tools, Prewarming을 실제 API에서 어떻게 사용하는지 자세히 설명합니다.
OpenAI — Introducing GPT-6 Sol and Luna
GPT-6 계열의 새로운 Prompt Caching과 Cached Input 최대 90% 할인, Reasoning Effort와 Tool 설정을 바꾸면서 Cache를 유지하는 방향을 확인할 수 있습니다.
Anthropic — Claude Opus 5.5 Model Overview
Opus 5.5의 Input·Output 가격, Cache Write·Read 가격, 1M Context와 기본 Medium Effort 등 기본 사양을 확인할 수 있습니다.
Anthropic — Effort
Claude에서 Top-level Effort를 변경하면 Cache가 다시 시작되는 이유와, Per-message Effort를 이용해 Cache를 유지하면서 특정 Turn의 Reasoning 깊이만 바꾸는 방법을 설명합니다.
Anthropic — Prompting Claude Opus 5.5
Opus 5.5에서 Medium Effort를 기본으로 사용하는 이유, High·XHigh·Max 사용 시 Thinking·Latency·Token이 늘어나는 특징과 Prompt Cache 관련 주의사항을 설명합니다.
'IT' 카테고리의 다른 글
| Claude Opus 5.5, 40% 싸지고 더 빨라졌다 (0) | 2026.09.24 |
|---|---|
| Codex와 Claude 플러그인 생태계 (0) | 2026.09.24 |
| Paseo로 여러 AI 코딩 에이전트를 한 팀처럼 쓰는 방법 (0) | 2026.09.24 |
| 클린 아키텍처가 뭐길래 (0) | 2026.09.24 |
| iPhone Duo UI 마이그레이션부터 자동 QA까지 (0) | 2026.09.24 |